PQC后量子密码
实现安全性的技术
IND-CCA-1攻击:攻击者只能在收到挑战密文之前提交选择的密文进行解密查询
IND-CCA-2攻击:攻击者在整个攻击过程中都可以提交选择的密文进行解密查询
IND-CPA攻击:攻击者可以在任何时间提交选择的明文并获得密文
FO变换(Fujisaki-Okamoto):用哈希函数绑定,解密时重新加密验证(ML-KEM、其他后量子KEM)
NTRU-HRSS
NTRU-HRSS是一种基于格的密钥封装机制,它是NTRU公钥密码系统的一个重要变体,专为后量子时代设计
算法链接:
https://csrc.nist.gov/CSRC/media/Projects/post-quantum-cryptography/documents/round-3/submissions/NTRU-Prime-Round3.zip
Kyber(ML-KEM)
FIPS 203 是美国国家标准与技术研究院(NIST)在2024年8月正式发布的 基于模块格的密钥封装机制标准,是NIST后量子密码标准化项目选出的首批算法之一。其技术基础是 CRYSTALS-Kyber
参数集
可变参数:𝑘、𝜂1、𝜂2、𝑑𝑢和𝑑𝑣
固定参数:𝑛= 256,𝑞= 3329<212
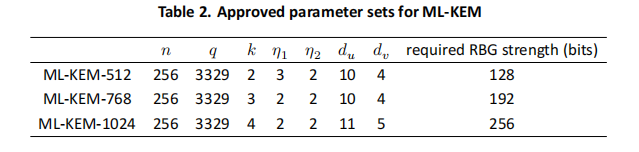
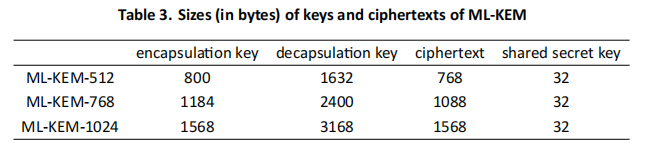
关键参数解释:
n=256: 所有参数集使用相同的环维度,即多项式有256个系数。q=3329(12比特): 所有参数集使用相同的模数,是一个便于计算的素数(接近2^12)。k: 模块维度。这是区分不同安全级别的核心参数。它决定了MLWE问题中“模块”的大小。k=2:公钥、密文由2个“向量”(多项式)组成。k=3:公钥、密文由3个“向量”(多项式)组成。k=4:公钥、密文由4个“向量”(多项式)组成。k越大,MLWE问题的维度越高,安全性越强,但密钥和密文尺寸也越大。η(Eta):中心二项分布(CBD)的参数,控制着误差(噪声)的大小。FIPS 203统一使用η=2
核心数学对象与运算
- 环:
R_q = ℤ_q[X] / (X^n + 1),其中n=256,q=3329。所有多项式运算在此环上进行(系数模q,多项式模X^256+1)。 - 模块:由
k个R_q中的多项式组成的向量(或k x k矩阵)。例如,ML-KEM-512的私钥s是一个2维向量(s0, s1),公钥矩阵A是一个2x2的矩阵。 - 中心二项分布 (CBD):用于生成保密的私钥向量和误差向量的概率分布。通过计算两个长度为
η的随机字节串的汉明重量差来采样。 - 位打包与压缩:
- 公钥压缩:使用模数
q到更少比特(如dq=12比特降到dq=12比特?实际不压缩公钥系数,但压缩密文)的“压缩”和“解压缩”函数,以减少通信开销。 - 密文压缩:对于向量
u和v,将其系数从模q(12比特)压缩到du=10或dv=4比特等,通过取模和四舍五入实现。解压时引入量化误差,这误差在解密时被设计为可以消除(通过四舍五入到最近倍数)。
辅助函数
PRF:哈希函数,PRFn(s,b) = SHAKE256(s||b),输出8 * 64 * n1比特,即64*n1字节,其中s占用32字节,n∈{2,3}
H:sha3-256 //输出32Byte
J:shake256 //输出32Byte
G:sha3-512 //输出32+32Byte
ByteEncode:pack,将多项式打包成字节流
ByteDecode:unpack,将字节流解包成多项式
SampleNTT:输入一个 32 字节的种子和两个索引,并输出一个属于集合 𝑇 的伪随机元素
Input: byte array 𝐵 ∈ 𝔹34 // a 32-byte seed along with two indices
Output: array a^ ∈Z256q //the coefficients of the NTT of a polynomial
SamplePolyCBD:输入一个种子,并输出来自分布 D𝜂(𝑅𝑞) 的一个伪随机样本
Input: byte array 𝐵 ∈ 𝔹64𝜂
Output: array 𝑓 ∈ ℤ256 //the coefficients of the sampled polynomial
NTT
Input: array 𝑓 ∈ ℤ256 𝑞 //the coefficients of the input polynomial
Output: array 𝑓^ ∈ ℤ256 q //the coefficients of the NTT of the input polynomial
INTT
Input: array 𝑓^ ∈ ℤ256 𝑞 //the coefficients of input NTT representation
Output: array 𝑓 ∈ ℤ256 𝑞 //the coefficients of the inverse NTT of the input
MultiplyNTTs
Input: Two arrays 𝑓^ ∈ ℤ256 𝑞 and g^ ∈ ℤ256 𝑞 //the coefficients of two NTT representations
Output: An array ℎ^ ∈ ℤ256 q //the coefficients of the product of the inputs
BaseCaseMultiply
Input: a0, a1, b0, b1 ∈ Zq // the coefficients of a0 + a1X and b0 + b1X
Input: y ∈ Zq // the modulus is X2-y
Output: c0,c1 ∈ Zq //the coefficients of the product of the two polynomials
密钥生成
K-PKE.KeyGen
输入:
d (32字节随机数)
输出
ekpke (384 * k + 32字节)
dkpke(384 * k字节)
流程:
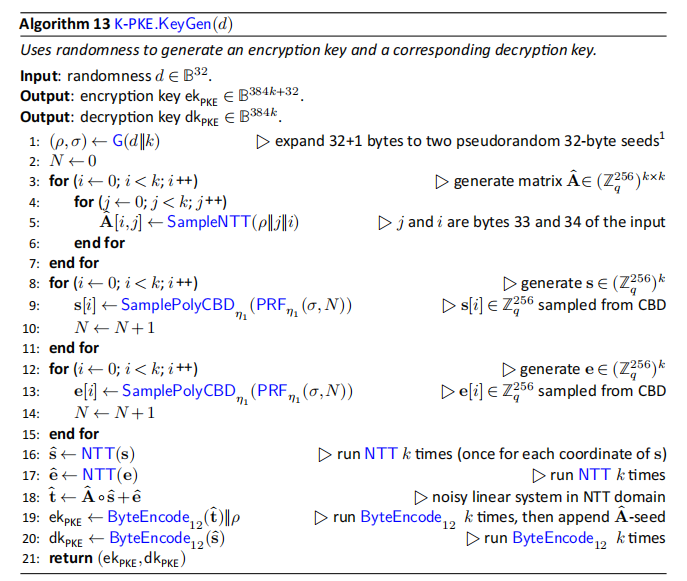
矩阵A:从ρ确定性地生成一个k x k的矩阵A,其元素属于环R_q上的多项式(多项式系数是模q的整数,范围[0,3328])。这是一个“伪随机”的公共矩阵
生成私钥和误差:
采样秘密向量 s ← CBD(σ),其中s是一个k维向量(k * 384字节),每个分量是一个多项式,每个多项式由 256 个系数组成,每个系数是 模 q 的整数(但 s 的系数来源于 CBD 分布,范围较小,仍用 12 比特格式编码)
采样误差向量 e ← CBD(σ),与s同理。
ML-KEM.KeyGen_internal
输入:
d:32字节随机数
z:32字节随机数
输出:
ek:加密密钥,384 * k+32字节
dk:解密密钥,768 * k+96字节
流程:
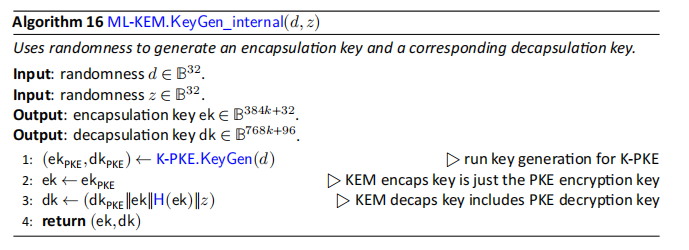
dk = dkpke||ek||H(ek)||z,其中dkpke解密密钥(s^向量,384 * k字节,k个打包多项式),ek是加密密钥,H(ek)是对ek的sha3-256,z是外部的32字节随机数,一共占用(384 * k)+(384 * k + 32)+32+32=768 * k+96字节
ek=ekpke=t^||p, 其中t^是长度为k的向量,每个分量是R_q中的一个打包多项式(256 个系数,每个系数模 q=3329,需要 12 比特,实际采用压缩的紧凑编码),每个系数是 0 ≤ 系数 < 3329(因为 3329 < 2¹²,所以需要 12 比特),占用k*384字节,p是G函数sha3-512对32字节随机数d级联1字节k派生出来的32字节。一共占用384 * k+32字节。
ML-KEM.KeyGen
输入:无
输出:
ek:加密密钥,384 * k+32字节
dk:解密密钥,768 * k+96字节
流程:
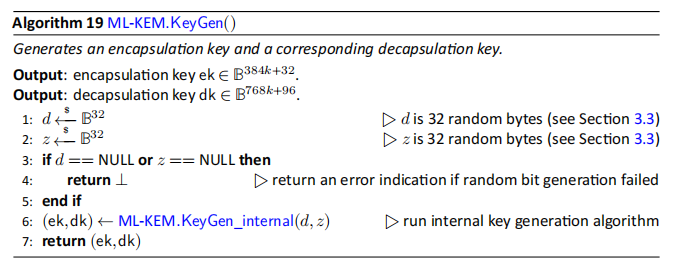
ek=ekpke=t^||p
| 参数集 | k | t^ 的字节数 (k×384) | ρ 的字节数 |
总 ek 长度 (字节) |
|---|---|---|---|---|
| ML-KEM-512 | 2 | 2 × 384 = 768 | 32 | 800 |
| ML-KEM-768 | 3 | 3 × 384 = 1152 | 32 | 1184 |
| ML-KEM-1024 | 4 | 4 × 384 = 1536 | 32 | 1568 |
dk = dkpke||ek||H(ek)||z,可以看到,解密密钥包含加密密钥ek,用于重新加密验证
| 参数集 | k | dkpke 长度 | ek长度 | H(ek)+z长度 | 总 sk 长度 (字节) |
|---|---|---|---|---|---|
| ML-KEM-512 | 2 | 768 | 800 | 64 | 768 + 800 + 64 = 1632 |
| ML-KEM-768 | 3 | 1152 | 1184 | 64 | 1152 + 1184 + 64 = 2400 |
| ML-KEM-1024 | 4 | 1536 | 1568 | 64 | 1536 + 1568 + 64 = 3168 |
计算流程优化
在上述K-PKE.KeyGen流程中,可以调整步骤用于节约存储:
1)计算ρ,σ
2)先计算秘密向量s并进行NTT变换得到s^,再进行矩阵A计算,每次计算一个A[i,j]即与s进行计算,无需存储全部的A
3)计算向量误差e并进行NTT运算得到e^
4)计算t = As + e,并完善计算ek dk
封装
K-PKE.Encrypt
输入:
pk:加密公钥(384 *k + 32字节)
m:明文(32字节)
r:随机值(32字节)
输出:
c:密文c1||c2( (du * k + dv)字节) //k+1个多项式,du是压缩向量u保留bit精度,dv是压缩向量v保留bit精度,d字节长度=256 * bit精度 / 8
流程:
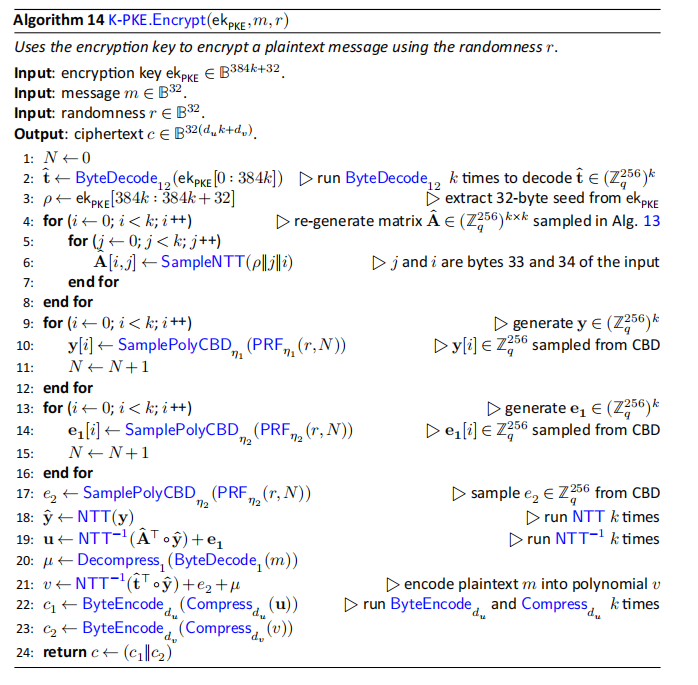
密文长度c = c1||c2
| c1 = k * compress(u, du) | c2 = compress(v, dv) | ct总长 | |
|---|---|---|---|
| K2 | 2 * (256 * 10 / 8) = 2 * 320 = 640 | 256 * 4 / 8 = 128 | 768 |
| K3 | 3 * (256 * 10 / 8) = 3 * 320 = 960 | 256 * 4 /8 = 128 | 1088 |
| K4 | 4 * (256 * 11 / 8) = 4 * 352 = 1408 | 256 * 5 / 8 = 160 | 1568 |
生成矩阵A‘:直接从ek加密密钥获取p,生成同样的A(或取其转置,取决于实现,这里其实可以考虑预计算了)
采样加密噪声:
采样误差向量 r ← CBD(r作为种子)
采样误差 e1 ← CBD(r作为种子)(一个k维向量)
采样误差 e2 ← CBD(r作为种子)(一个k维向量)
计算密文:
u = Aᵀ ◦ r + e1 (一个k维向量)
v = tᵀ ◦ r + e2 + Decompress(Decode(m), 1)。这里m被编码并解压缩到R_q的一个元素,然后加到结果中。tᵀ ◦ r是向量点积
压缩与输出:
将u和v的系数进行压缩(例如,u压缩到10比特,v压缩到4比特),得到密文c = (Compress(u, du), Compress(v, dv))
输出(c, K),其中K = KDF(K̄)是最终的共享密钥
注意事项:在封装密钥时,标准要求需要对外部公钥ek进行验证,来确保多项式系数都在[0,q-1]范围,12bit能覆盖的值可以比q大。但是验证本身不能保证公钥的正确性,只是格式的有效性。防止使用恶意构造的公钥导致安全问题。
ML-KEM.Encaps_internal
输入:
ek:加密密钥,384 * k+32字节
m:明文(32字节随机数)
输出:
K:共享密钥,32字节
c:密文,32 * (du * k+dv),,共32 * (k+1)*384字节
流程:
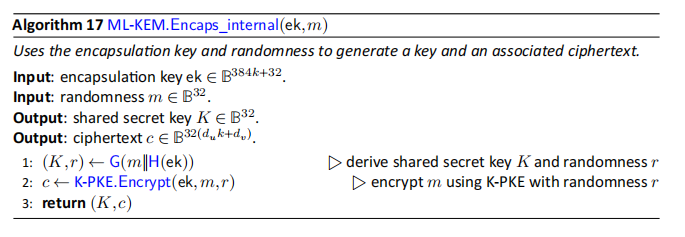
ML-KEM.Encapsulation
输入:
ek:加密密钥,384 * k+32字节
输出:
K:共享密钥32字节
c:加密密文,32 * (du * k+dv),共32 * (k+1)*384字节
流程:
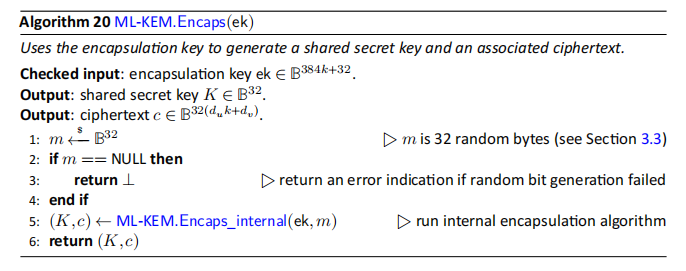
在执行上述之前,需要对加密密钥进行检查:
1)检查加密密钥长度是否满足384*k+32字节
2)对密钥前384 * k进行unpack再进行pack,查看是否一致
解封装
K-PKE.Decrypt
输入:
dkpke :解封装密钥,占用384*k字节
c:密文,占用32 * (du * k+dv)字节 //k+1个多项式
输出:
m:明文,32字节
流程:
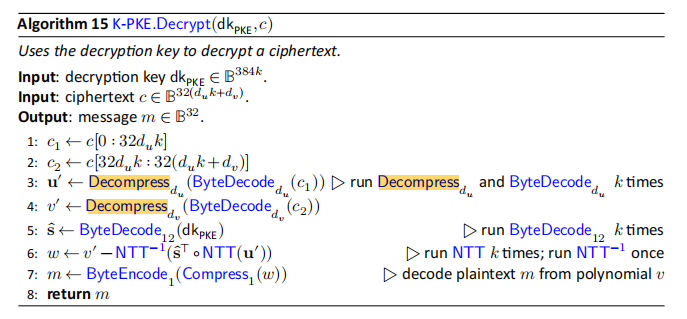
1)解压缩密文:从c恢复u' = Decompress(u, du)和v' = Decompress(v, dv)
ML-KEM.Decaps_internal
输入:
dk:解密密钥,768 * k + 96字节
c:密文,占用32 * (du * k+dv)字节 //k+1个多项式,每个多项式按d比特压缩
输出:
K:共享密钥,32字节
流程:
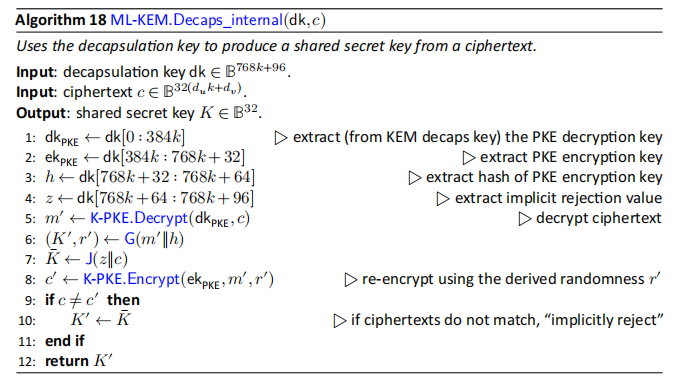
流程:
1)重新加密验证 (CCA安全的关键):
使用恢复的m'和r‘,和存储的ekpke,完全重新执行一遍封装流程,得到一个新的密文c*和封装的秘密K̄*
比较计算出的c*与接收到的c是否完全一致
ML-KEM.Decapsulation
输入:
dk:解封密钥,768*k+96字节
c:密文,占用32 * (du * k+dv)字节 //k+1个多项式,每个多项式按d比特压缩
输出:
K:协商密钥,32字节
流程:
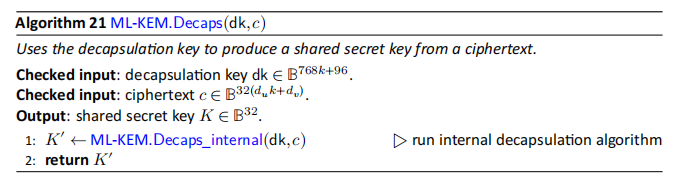
在解封装之前,需要判断:
1)密文长度,如果c长度不满足32 * (du * k+dv),报错
2)解封密钥,如果长度不满足768*k+96,报错
3)对dk = dkpke||ek||H(ek)||z,计算H(dk[384 * k:784 * k+32])与dk[768 * k+32:768 * k+64]是否等价
输入:密文 c,私钥 sk(包含s, pk, z, h等)
输出:共享密钥 K
安全版本运算
密钥生成
//ML-KEM.keygen
input:
  d0: 32 random byte d0,
  d1: 32 random byte d1,
  z:  32 random byte z
output:
  ek: 384k+32 byte
  dk: 1152k+96 byte dk=dk0_pke||dk1_pke||ek||H(ek)||z
算法流程
1. 检查d0, d1, z输入是否为NULL
2. K-PKE.Keygen
3. H(ek)
4. return dk
5. return ek

//K-PKE.Keygen
1.输入d0, d1
2.p,sigma = Gsec(d0||k,d1||0) //p和sigma带掩
3.输出dk.rho(z), ek.rho(p)//p 脱掩
4.s0,s1 = CBDsec()
5.s0,s1 = nttsec(s0, s1) //输入算术,输出算术
6.dk0 = encode12(s0)
7.dk1 = encode12(s1)
8.输出dk.dk0, 输出dk.dk1
9.循环L次s=s0+s1, shuffle
10.循环K-1次 begin
      循环L次A=SampleNTT(rho)(这里的rho = rho0 xor rho1)
      循环L次A*s, shuffle
   循环K-1次 end
11.循环K次e0, e1 = CBDsec()
12.循环K次nttsec(e0, e1)
13.循环K次t=As+e, shuffle
14.encode12(t)
15.输出dk.ek,输出ek.ek
16.H(ek)
17.输出H(ek)
封装
//ML-KEM.Encaps
input:
  ek:384k+64 byte
output:
  K:32 byte
  c:32(du*k+dv) byte
算法流程
1.ek lenth check
2.generate m0,m1
3.check m0, m1
4.H(ek)
5.Gsec(m0||H(ek), m1||0)
6.K-PKE. Enc_sec & ek modulus check
7.return K, c

//K-PKE. Enc_sec
1.输入ek.ek,输入ek.rho
2.H(ek)
3.输入m0, m1
4.Gsec(m0||H(ek), m1||0)
5.输出K0,输出K1
6.y0, y1 = CBDsec()
7.y0, y1 = nttsec(y0, y1)
8.循环K-1次 begin
      循环L次A=SampleNTT(rho)
      循环L次A*y, 用shuffle
  循环K-1次 end
9.intt_sec(Ay)
10.循环K次e1_0,e1_1 = CBD_sec()
11.循环K次u=intt(Ay)+e1_0, shuffle
12.循环K次u=u+e1_1
13.c1 = compress(u)
14.输出c1
15.输入ek.ek
16.t=decode12(ek)
17.t*y,用shuffle
18.intt_sec(ty)
19.e2 = CBD()
20.v=intt(ty)+e2, shuffle
21.mu=decompress(m)
22.v=v+mu
23.compress(v)
24.输出c2
解封装
//ML-KEM.Decaps
input:
  dk:768k+96 byte
  c:32(du*k+dv) byte
output:
  K:32 byte
算法流程
1.hash_check
2.J(z||c)
3.K-PKE. Dec_sec
4.Gsec(m0'||h, m1'||0)
5.K-PKE. Enc_sec
6.cmp(c, c')
7.check(c)
8.return K’

//K-PKE. Dec_sec
1.输入ek.ek 输入ek.rho 输入h
2.cmp(H(ek), h)
3.J(z||c):输入c 输入z
4.u=decompress(c1)
5.v=decompress(c2)
6.ntt(u)
7.输入dk0
8.decode12(dk0)
9.s0*u
10.intt(s0u)
11.w0=v-s0u
12.输入dk1
13.decode12(dk1)
14.s1*u
15.intt(s1u)
16.w1 = -intt(s1u)
17.m0, m1 =compress_sec(w0, w1)
18.sha3_512:Gsec(m0'||h, m1'||0)
19.CBDsec(y0, y1)
20.nttsec(y0, y1)
21.循环L次A=SampleNTT(rho)
      循环L次A*y, 用shuffle
22.intt_sec(Ay)
23.循环K次e1_0, e1_1 = CBD_sec()
24.循环K次u0=intt(Ay)+e1_0, shuffle
25.循环K次u1[i]=e1_1
26.compress_sec(u0, u1)
27.输出c1_0', c1_1'
28.输入ek.ek
29.t=decode12(ek) (复用ek.ek)
30.t*y,用shuffle
31.intt_sec(ty)
32.CBD(e2)
33.v0=intt(ty)+e2, shuffle
34.mu0=decompress(m0')
35.v0=v0+mu0
36.v1=decompress(m1')
37.c2_0, c2_1 = compress_sec(v0, v1)
38.输入c2_0, c2_1
39.(c2 - c2_0') % 2^d
40.a = crc((c2 - c2_0') % 2^d)
41.b = crc(c2_1'% 2^d)
42.cmp(a, b)
43.randomdelay
44.cmp(a, b)
45.输入c1
46.输入c1_0', c1_1'
47.(c1 - c1_0') % 2^d
48.a = crc((c1- c1_0') % 2^d)
49.b = crc(c1_1'% 2^d)
50.cmp(a, b)
51.randomdelay
52.cmp(a, b)
53.输出K0, K1
Dilithium(ML-DSA)
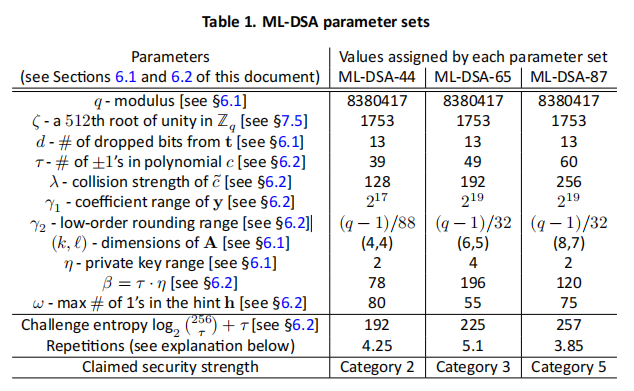
CRYSTALS-Dilithium 是NIST在2022年选定的后量子数字签名标准之一(与Falcon、SPHINCS+并列),基于格密码学(Lattice-Based Cryptography)。
数学基础
困难问题:模块格上的短整数问题(Module - SIS)
安全参数:
    安全性基于格上最坏情况下的复杂性假设
    3个安全级别(NIST Level 1/3/5对应128/192/256比特经典安全)
密钥结构
| 组件 | 大小 | 描述 |
|---|---|---|
| 私钥(sk) - K * L多项式矩阵 | ~2.5KB | 短向量矩阵+随机种子 |
| 公钥(pk) - L * 1 短向量矩阵 | ~1.5KB | 模块格上的矩阵 |
| 签名 | ~2.7KB | 响应向量+掩码 |
注:相比RSA-3072(签名=384B),密钥较大但运算更快
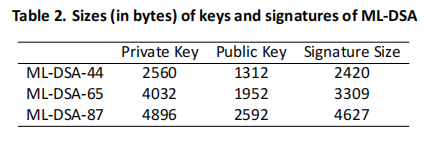
参数集
辅助函数
Pure:      M' = 0x00 ‖ ctx_len ‖ ctx ‖ M            (原始消息M可任意长)
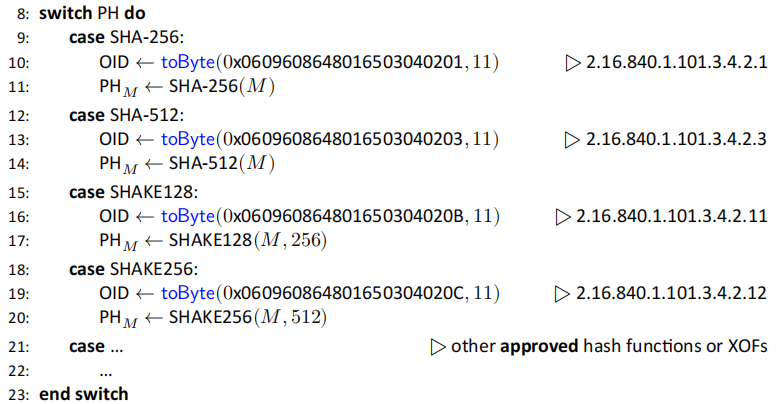
Pre-hash:  M' = 0x01 ‖ ctx_len ‖ ctx ‖ OID ‖ PH(M)  (PH(M)是固定长度的哈希值),ctx长度在[0,255]字节
Raw:       M' = M                                   (直接透传,M' 作为变长输入)
μ = SHAKE256(tr ‖ M') (64字节),其中tr = SHAKE256(pk, 64) 是公钥的哈希,M' 的构造和 205 一样取决于模式
计算μ值:
输入:
mode:消息模式,raw/pure/pre-hash
dilithium模式:44/64/87,安全强度
msg:取决mode,raw和pure传入的是原始消息,pre-hash是对hash处理的摘要值
oid:预计算hash算法的DER OID(仅限于pre-hash使用)
sk:私钥,SK = ρ ‖ K ‖ tr ‖ s₁ ‖ s₂ ‖ t0
pk:公钥,PK = ρ ‖ t1
输出:
μ:64 字节
需要注意的是,传入的oid需要是对hash处理的摘要算法保持一致
密钥生成
输入:
种子:32字节
输出:
sk:私钥,ρ ‖ K ‖ tr ‖ s₁ ‖ s₂ ‖ t0
pk:公钥, ρ ‖ t1
其中,ρ是32字节,K是32字节,tr是64字节,t1,s1,s2,t0都是向量
签名
输入:
mu:预处理的消息,64字节
sk:私钥,ρ ‖ K ‖ tr ‖ s₁ ‖ s₂ ‖ t0
rand:随机数,32字节
输出:
sig:签名值,c || z || h
签名值占用如下:
| ML-DSA-44 | ML-DSA-65 | ML-DSA-87 | |
|---|---|---|---|
| c | 32 | 48 | 64 |
| z | 2304 | 3200 | 4480 |
| h | 84 | 61 | 83 |
| 总计 | 2420 | 3309 | 4627 |
验签
输入:
mu:预处理的消息,64字节
sig:签名值,c || z || h
pk:公钥, ρ ‖ t1
输出:
sig:签名值,c || z || h
性能表现
运算效率(x64 CPU基准)
| 操作 | 周期数 | 对比RSA-3072 |
|---|---|---|
| 签名生成 | ~500K | 快5x |
| 签名验证 | ~200K | 快20x |
| 密钥生成 | ~100K | 快100x |
资源占用优势
无大数运算:仅需多项式乘法(适合嵌入式设备)
并行化友好:矩阵运算可SIMD加速(AVX2指令集)
安全性分析
抗量子攻击能力
已知最优攻击需>2128次格规约运算(即使使用量子算法)
侧信道防御
内置对抗措施:
- 签名时添加高斯噪声(防定时攻击)
- 拒绝采样机制(放信息泄露)
需注意实现:
- 多项式乘法需恒定时间实现
- 随机数生成必须符合NIST SP 800-90B
Hints 用于标识签名 zz 中需要模约减的系数位置,以确保验证时能正确恢复 w=A⋅z−c⋅t
在 CRYSTALS-Dilithium 算法中,Hint Make(生成提示)和 Use Hint(使用提示)是两个关键步骤,用于优化签名的验证过程
Hint Packing(提示打包)和 Hint Unpacking(提示解包)是为了优化签名大小而设计的关键步骤,主要用于压缩签名中的辅助信息(hints)
SLH_DSA(SPHINCS+)
数学基础
密钥结构
参数集
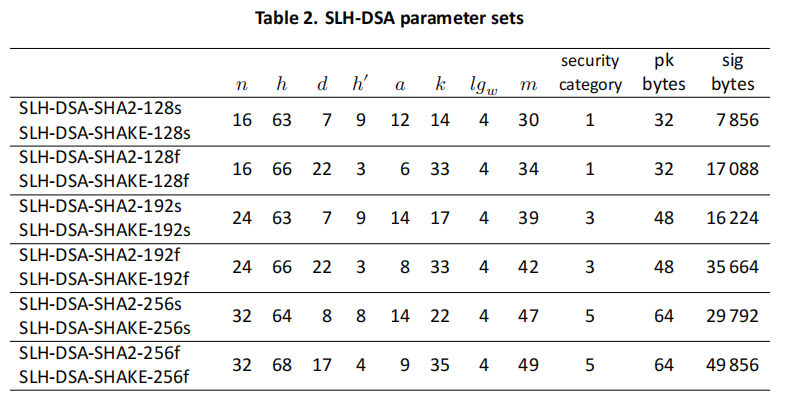
不同模式的S和F区别:
| S(Small) | F(Fast) | |
|---|---|---|
| 签名大小 | 小 | 大(约3-5倍于S) |
| 签名速度 | 慢 | 快 |
| 验签速度 | 慢 | 快 |
| 适用场景 | 宽带/存储受限 | 实时性要求高 |
辅助函数
Pure:      M' = 0x00 ‖ ctx_len ‖ ctx ‖ M            (原始消息M可任意长)
Pre-hash:  M' = 0x01 ‖ ctx_len ‖ ctx ‖ OID ‖ PH(M)  (PH(M)是固定长度的哈希值),ctx长度在[0,255]字节
Raw:       M' = M                                   (直接透传,M' 作为变长输入)
输入:
sk_prf:私钥分量,其中SK = SK.seed ‖ SK.prf ‖ PK.seed ‖ PK.root,共4*n字节
opt_rand:随机数,n字节
M’:原始消息(raw) / 格式化原始消息(pure) / 格式化原始消息的摘要(pre-hash)
输出:
R:n字节
R = PRFmsg(sk_prf, opt_rand, M')
输入:
R:n字节
公钥分量:PK=PK.seed||PK.root,一共2n字节
M’:原始消息(raw) / 格式化原始消息(pure) / 格式化原始消息的摘要(pre-hash)
输出:
digest:摘要,长度m字节
digest = Hmsg(R, PK_seed, PK_root, M')
总结:
- PRFmsg基于私钥,随机数,原始消息,产生n字节随机数R;R是签名组成的一部分(SIG=R||SIG_FORS||SIG_HT)
- Hmsg基于R,公钥分量,原始消息,产生m字节待签名摘要digest
密钥生成
输入:
SK.seed: 私钥种子(n字节),派生 WOTS+ / FORS 的私钥
SK.prf:私钥分量,PRFmsg 的密钥,用于生成随机数 R,n字节
PK.seed:公钥种子(n字节),n字节
输出
SK = SK.seed || SK.prf || PK.seed || PK.root (4n字节),PK.root由算法计算得到
PK = PK.seed || PK.root (2n字节),PK.root由算法计算得到
流程:
签名
输入:
mode:模式
sk:私钥,SK.seed || SK.prf || PK.seed || PK.root (4n字节)
h_msg_digest:Hmsg函数的输出,m字节
sig_r:
输出:
sig:签名值,数据结构为SIG=R||SIG_FORS||SIG_HT
其中,R代表PRFmsg产生的n字节随机数,SIG_FORS是k颗FORS子树的签名,占用k(a+1)n字节,SIG_HT代表d层XMSS签名(每层包含 WOTS+ 签名 + 认证路径),占用d(len+h/d)n字节,一共占用[1 + k(a+1) + d(len + h/d)] × n 字节
验签
输入:
mode:模式
h_msg_digest:hmsg函数输出,m字节
pk:PK.seed||PK.root,2n字节
sig:签名值,
输出:
成功或失败
LMS
参考标准《RFC8554》
LM-OTS签名
签名用于通过将秘密私钥与共享公钥关联来验证消息的真实性。这些是一次性签名;每个私钥最多只能用于一次对任何给定消息进行签名。
作为签名过程的一部分,使用加密哈希函数H(参见第4.1节)计算原始消息的摘要,并对生成的摘要进行签名。
参数
n:哈希函数输出的字节数
w:Winternitz coefficients的位宽度,即单个 Winternitz 链中使用的哈希值或校验和的位数。它是集合 { 1, 2, 4, 8 } 中的一个成员。参数w确定作为OTS签名一部分计算的Winternitz链的长度(涉及2^w-1次哈希函数调用)
p:构成 LM-OTS 签名的 n 字节字符串元素的数量。它是 n 和 w 的函数;定义参数集的值列于表 1;也可以通过附录 B 中给出的算法计算。
ls:校验和函数Cksm总使用的左移位位数(定义见4.4节)。
H:抗第二原像攻击加密哈希函数,接受任意长度字节,输出固定长度字符串
w的取值对安全几乎没有影响。增加w将缩短签名(切分块=m/w,w增大分块减少),但生成(总哈希调用次数增加,m_bit/w * (2w-1)可以看出)和验证签名的计算量会增加。
p和ls的值取决于参数n和w的选择,表1说明了n、w、p和ls的各种组合以及产生的签名长度
| Parameter Set Name | H | n | w | p | ls | u=消息分段组数(推算) | v=cks组数(推算) | sig_len |
|---|---|---|---|---|---|---|---|---|
| LMOTS_SHA256_N32_W1 | SHA256 | 32 | 1 | 265 | 7 | 256 | 9 | 8516 |
| LMOTS_SHA256_N32_W2 | SHA256 | 32 | 2 | 133 | 6 | 128 | 5 | 4292 |
| LMOTS_SHA256_N32_W4 | SHA256 | 32 | 4 | 67 | 4 | 64 | 3 | 2180 |
| LMOTS_SHA256_N32_W8 | SHA256 | 32 | 8 | 34 | 0 | 32 | 2 | 1124 |
注意:上表v代表checksum的分组数量,每个分组w位宽,从上表可知,无论何种参数,都需要使用2个字节可以表示全部type的Cks
参数ls和p的计算如下:
 u = ceil(8*n/w) //ceil向上取整
 v = ceil((floor(lg((2^w - 1) * u)) + 1) / w) //floor向下取整,lg底数为2
 ls = 16 - (v * w)
 p = u + v
//u:消息所需的w位字段数
//v:校验和字节字符串所需的w位字段数

//以LMOTS_SHA256_N32_W8举例
u = ceil(8*32/8) = 32 //消息被分成32个块,每个块8bit
v = ceil((floor(lg((2^w - 1) * u)) + 1) / w) //v可以理解为checksum数量
  = ceil((floor(lg((2^8 - 1) * 32)) + 1) / 8)
  = ceil((floor(X) + 1) / 8) //X=lg((2^8 - 1) * 32)=lg(255 * 32)=lg(8160) ,12<lg(8160)<13,底数是2,log2(8160) ≈ 12.994
  = ceil((12 + 1) / 8)
  = ceil(13/8)
  = 2
ls = 16 - 2*8 = 0
p = 32+2=34

//sign_len
|sig| = typecode||C||y[1]||...||y[32]
1124 = 4+n+p*n=4+32+p*32=36+34*32=36+1088=1124
私钥
LM-OTS私钥格式是实现的内部问题,本标准不对其进行定义。
==一种可能性是私钥由表示特定LM-OTS算法的类型码、包含p个n字节字符串、16字节字符串l,和4字节字符串q。==
私钥最多对一个消息进行签名
算法0:
- 从LM-OTS私钥将与之一起使用的LMS树中检索q和l值(LMS公钥/私钥对的16字节标识符)
- 将type设置为算法的typecode
- 根据typecode和表1设置n和p
- 按如下方式设置数组x:
- for(int i=0;i<p;i++) x[i] = rand() //该部分可以使用伪随机计算,但会影响密码强度
- 返回u32str(type) || I || u32str(q) || x[0] || x[1] || ... || x[p-1]
//type取值:
enum lmots_algorithm_type {
 lmots_reserved       = 0,
 lmots_sha256_n32_w1  = 1,
 lmots_sha256_n32_w2  = 2,
 lmots_sha256_n32_w4  = 3,
 lmots_sha256_n32_w8  = 4
};
从官方标准cmodel看,LM-OTS私钥生成遵循了附录A规定了LMS私钥的生成
//l为16字节,SEED为m字节,m为H输出字节数,在开始时统一生成
x_q[i] = H(l || u32str(q) || u16str(i) || u8str(0xff) || SEED). //私钥长度固定,为
公钥
LM-OTS公钥通过将函数H迭代应用于x的每个单独元素,进行2^w-1次迭代,然后散列所有结果值,从私钥生成。
算法1:
-
将type设置为算法的typecode
-
根据类型代码和表1设置整数n、p、w
-
根据私钥确定x、l和q
-
按如下方式计算字符串k:
C
   for(i=0;i<p;i++)
   {
       tmp = x[i]
    for(j=0;j<2^w-1;j++)
       {
           tmp = H(l || u32str(q) || u16str(i) || u8str(j) || tmp)
       }
       y[i] = tmp
   }
   K = H(l || u32str(q) || u16str(D_PBLC) || y[0] || ... || y[p-1])
其中,D_PBLC是固定的两字节值0x8080,用于区分此系统中的最后一个散列和其他所有散列
- return u32str(type) || I || u32str(q) || K
从公钥值长度看,是个固定值,长度为4+16+4+N=24+N,N为hash输出字节长度
注:公钥是算法1返回的值
校验和
校验和用于确保能够检测到任何操纵现有签名元素的伪造企图。之所以需要此校验和,是因为攻击者可以自由推进任何Winternitz链。也就是说,如果该校验和不存在,则攻击者可以找到每一位都大于有效哈希值的哈希值来替换它(并调整Winternitz链条)。
算法2:
//byte(S,0)是S最左边字节,byte(S,1)是左边开始的第二个字节,byte(S,n-1)是S最右边字节
coef(S, i, w) = (2^w - 1) & (byte(S, floor(i * w / 8)) >> (8 - (w * (i % (8 / w)) + w)) )

sum = 0
for (i=0; i< n*8/w; i++) //n是哈希摘要输出字节数
{
    sum += sum + (2^w -1) - cofe(S, i, w)//S表示输入到该函数的n字节字符串
}
return (sum << 1s) //ls值见表1,sum值总和为16位无符号整数
由于左移位操作,Cksm结果的最右边的位通常为零。由于p的值,这些位在签名生成或验证期间不会使用。
校验和(见第 4.4 节)使用非负整数“sum”计算,其宽度选定为 w 位字段的整数个数,使其能够容纳函数 H(定义见第 4.5 节的签名算法)的总可能应用次数与实际应用次数之差。如果 H 的执行次数为 0,则 sum 为 (2^w - 1) * (8*n/w)。因此,在本文档中,描述了基于 H = SHA256(n = 32 字节)和 w = { 1, 2, 4, 8 } 的签名方法,==sum 变量是一个 16 位非负整数==,适用于 n 和 w 的所有组合。计算使用第 4.1 节中定义并在附录 B 中计算的参数 ls,该参数表示左移运算中使用的位数。
签名生成
通过依次执行以下操作生成消息的LM-OTS签名:将LMS密钥标识符I、LMS叶标识符q、值D_MESG(0x8181)和随机化器C前置到消息(==这里的消息是指原始待签名的消息,任意长度==);计算散列;将哈希的校验和连接到哈希本身;将结果值视为w位值序列;以及使用每个w位值来确定将函数H应用于私钥的对应元素的次数。函数H的输出连接在一起并作为签名返回。此过程的伪代码如下所示。
算法3:
-
将type设置为算法的typecode,占用4字节
-
根据类型代码和表1设置n、p、w
-
根据私钥确定x、l、q
-
将C设置为统一随机的n字节字符串
-
按如下方式计算数组y:
C
   //C占用n字节,D_MESG占用2字节
   //l是16字节字符串,用于指示此LM-OTS与哪个Merkle树一起使用。当LM-OTS签名系统在N次签名系统之外使用时,值I可用于区分此一次性签名与其他签名;但是,值q必须设置为全零值。
   //q占用4字节,表示OTS公钥出现的Merkle树的叶子序号
   Q = H(l || u32str(q) || u16str(D_MESG) || C || message) //D_MESG (0x8181)
   for ( i = 0; i < p; i = i + 1 )
   {
        a = coef(Q || Cksm(Q), i, w)
        tmp = x[i] = H(l || u32str(q) || u16str(i) || u8str(0xff) || SEED)
        for ( j = 0; j < a; j = j + 1 )
        {
            tmp = H(l || u32str(q) || u16str(i) || u8str(j) || tmp)
        }
        y[i] = tmp
   }
- Return u32str(type) || C || y[0] || ... || y[p-1]
注意,该算法产生的签名的元素是第4.3节中公钥算法计算的元素中间值
签名是算法3返回的字符串。第3.3节将字符串的结构正式定义为lmots_signature联合。
签名验证
为了验证带有签名的消息(n字节字符串的数组,表示为y),接收方必须使用消息散列及其校验和串联产生的字符串的w位系数“完成”H的迭代链。此计算应产生与提供的公钥匹配的值。
算法4a:解析公钥
- 如果公钥长度<4个字节,返回INVALID
- 从公钥解析pubtype,l、q和k,如下:
- )pubtype = strTou32(pubkey前4个字节)
- )l = 下一个16字节的公钥
- )q = strTou32(公钥的下4字节)
- )k = 公钥的下n个字节 // 由此可知,pubkey=pubtype || l || q || k,一共4+16+4+N个字节
- 使用算法4b,从签名、消息、pubtype以及从公钥获得的标识符I和q计算公钥候选Kc。如果算法4b返回INVALID,则返回INVALID。
- 如果Kc等于k,则返回有效值,否则,返回无效
算法4b:根据签名、消息、签名类型码pubtype和标识符I、q计算公钥候选Kc
-
如果签名长度<4字节,则返回INVALID
-
从签名中解析sigtype、C和y,如下所示
-
)sigtype = strTou32(签名的前4个字节)
- )如果sigtype不等于pubtype,则返回INVALID
- )根据pubtype和表1设置n和p,如签名长度不完全为4+n*(p+1)字节,则返回INVALID
- )C=签名的下n个字节
-
)y[0]=签名的下一个n字节,y[1]=签名的下一个n字节...y[p-1]=签名的下一个n字节 //由此C||y长度=n*(p+1)
-
计算Kc
C
   Q = H(l || u32str(q) || u16str(D_MESG) || C || message)
   for ( i = 0; i < p; i = i + 1 )
   {
       a = coef(Q || Cksm(Q), i, w)
       tmp = y[i]
       for ( j = a; j < 2^w - 1; j = j + 1 )
       {
            tmp = H(l || u32str(q) || u16str(i) || u8str(j) || tmp)
       }
       z[i] = tmp
   }
   Kc = H(l || u32str(q) || u16str(D_PBLC) || z[0] || z[1] || ... || z[p-1])
LMS性能对比
| Parameter Set Name | w | p | h | sig_len (4+4+32+p 32+4+h 32) |
Verify hash (Avg) |
Speed (10Mhz LP) |
|---|---|---|---|---|---|---|
| LMOTS_SHA256_N32_W1 &LMS_SHA256_M32_HX | 1 | 265 | [5,10,15,20,25] | 8.6K~9.3K | 390ms/次 | |
| LMOTS_SHA256_N32_W2 & LMS_SHA256_M32_HX | 2 | 133 | [5,10,15,20,25] | 4.5K~5.1K | ||
| LMOTS_SHA256_N32_W4 & LMS_SHA256_M32_HX | 4 | 67 | [5,10,15,20,25] | 2.3K~3.0K | ||
| LMOTS_SHA256_N32_W8 & LMS_SHA256_M32_HX | 8 | 34 | [5,10,15,20,25] | 1.2K~1.9K |
统计LMS计算过程中一次性hash次数
| 密钥(只计算一次) | 签名 | 签名(平均,预存储) | 验签(平均) | M树所有节点hash存储 | M树叶节点hash存储 | |
|---|---|---|---|---|---|---|
| W8_H5 | 2^5 * (34*(1+256))+2^5-1=279647 | 2^5 * (34*(1+255))+5=278533 | 1*(34 * 128)=4,352 | 34*128+5=4357 | 32 * 32+31 * 32=2016=2KB | 32 * 32=1KB |
| W8_H10 | 2^10 * (34*(1+255)) + 2^10-1=8913919 | 2^10 * (34*(1+255))+10=8912906 | 1*(34 * 128)=4,352 | 34*128+10=4362 | 1024 * 32+1023 * 32=65504B=64KB | 1024 * 32=32768B=32KB |
| W8_H15 | 2^15 * (34*(1+256))+2^15-1=285245439 | 2^15 * (34*(1+255))+15=285212687 | 1*(34 * 128)=4,352 | 34*128+15=4367 | 32768 * 32+32767 * 32=2097120B=2M | 32768 * 32=2097120B=1M |
| 密钥(只计算一次) | 签名 | 签名(平均,预存储) | 验签(平均) | M树所有节点hash存储 | M树叶节点hash存储 | |
|---|---|---|---|---|---|---|
| W1_H5 | 2^5 * (265*(1+1))+2^5-1=16991 | 同左 | 1*(265 * 0.5)=133 | 265*0.5+5=138 | 同W8_H5 | 同W8_H5 |
| W1_H10 | 2^10 * (265*(1+1))+2^10-1=543743 | 同左 | 1*(265 * 0.5)=133 | 265*0.5+10=143 | 同W8_H10 | 同W8_H10 |
| W1_H15 | 2^15 * (265*(1+1))+2^15-1=17399807 | 同左 | 1*(265 * 0.5)=133 | 265*0.5+15=148 | 同W8_H15 | 同W8_H15 |
| 密钥(只计算一次) | 签名 | 签名(平均,预存储) | 验签(平均) | M树所有节点hash存储 | M树叶节点hash存储 | |
|---|---|---|---|---|---|---|
| W2_H5 | 2^5 * (133*(1+4))+2^5-1=21311 | 同左 | 1*(133 * 1.5)=200 | 133*1.5+5=215 | 同W8_H5 | 同W8_H5 |
| W2_H10 | 2^10 * (133*(1+4))+2^10-1=681983 | 同左 | 1*(133 * 1.5)=200 | 133*1.5+10=210 | 同W8_H10 | 同W8_H10 |
| W2_H15 | 2^15 * (133*(1+4))+2^15-1=21823487 | 同左 | 1*(133 * 1.5)=200 | 133*1.5+15=215 | 同W8_H15 | 同W8_H15 |
| 密钥(只计算一次) | 签名 | 签名(平均,预存储) | 验签(平均) | M树所有节点hash存储 | M树叶节点hash存储 | |
|---|---|---|---|---|---|---|
| W4_H5 | 2^5 * (67*(1+16))+2^5-1=36479 | 同左 | 1*(67 * 7.5)=503 | 67 * 7.5+5=508 | 同W8_H5 | 同W8_H5 |
| W4_H10 | 2^10 * (67*(1+16))+2^10-1=1167359 | 同左 | 1*(67 * 7.5)=503 | 67 * 7.5+10=513 | 同W8_H10 | 同W8_H10 |
| W4_H15 | 2^15 * (67*(1+16))+2^15-1=37355519 | 同左 | 1*(67 * 7.5)=503 | 67 * 7.5+15=518 | 同W8_H15 | 同W8_H15 |
总结
//签名值表示
sig=type||C||y[0]||..||y[p-1]
//对消息hash预处理,得到Q
Q = H(I||q||8181||C||message)
for ( i = 0; i < p; i = i + 1 )
{
     a = coef(Q || Cksm(Q), i, w)
     tmp = x[i] //这里x[i]参考私钥表示:x[i]=H(I||u32str(q)||u16str(i)||u8str(0xff)||SEED)
     for ( j = 0; j < a; j = j + 1 )
     {
         tmp = H(I || u32str(q) || u16str(i) || u8str(j) || tmp)
     }
     y[i] = tmp
}

//私钥表示(标准没有规定格式)
priv=type||I||q||x[0]||...||x[p-1]
//附录A指定求私钥方式
x[i]=H(I||u32str(q)||u16str(i)||u8str(0xff)||SEED)

//公钥表示
pubkey=type||I||q||K
K=H(I||q||8080||y[0]||...||y[p-1])
for(i=0;i<p;i++)
{
    tmp = x[i]//这里x[i]参考私钥表示:x[i]=H(I||u32str(q)||u16str(i)||u8str(0xff)||SEED)
    for(j=0;j<2^w-1;j++)
    {
        tmp = H(I || u32str(q) || u16str(i) || u8str(j) || tmp)
    }
    y[i] = tmp
}
K = H(l || u32str(q) || u16str(D_PBLC) || y[0] || ... || y[p-1])
Leighton-Micali Signatures
Leighton-Michali签名(LMS)方法可以对大量但固定数量的消息进行签名。LMS系统使用两个加密组件:一次性签名方法和哈希函数。每个LMS公钥/私钥对与一个完美二叉树相关联,其中每个节点包含一个m字节值,其中m是哈希函数的输出长度。树的每个叶包含LM-OTS公钥/私钥对的公钥值。树的根包含的值是LMS公钥。通过将哈希函数应用于其子节点的值的串联来计算每个内部节点。

树的每个节点都与一个节点编号相关联,这是一个无符号整数,在下面的算法中表示为node_num,计算如下。根节点具有节点编号1;对于节点号N<2<sup>h(其中h是树的高度)</sup>的每个节点,其左子节点号为2*N,而其右子节点号为2*N+1。这样做的结果是树中的每个节点都有一个唯一的节点号,叶子的节点号为2<sup>h</sup>,(2<sup>h</sup>)+1,(2<sup>h</sup>)+2,…(2<sup>h</sup>)+(2<sup>h</sup>)-1。通常,第i级的第j个节点的节点号为2<sup>i</sup>+j。当LMS算法中需要节点数时,可以方便地计算节点数,如这些算法中所述。
由上可知,根节点的编号是1,节点号不包含叶子节点,假设一个满二叉树前序遍历为:ABDECFG
      A
      |
    |   |
    B   C
    |   |
   | | | |
   D E F G
A的编号为1,ABCDEFG的编号依次为1234567,G的编号为7,树高度h为2(从0开始编号)
节点号(不含叶子节点)N<2^2 => 3<4
叶子节点DEFG=4,5,6,7 => 2^2, 2^2+1,2^2+2,2^2+3
比方说第2级(从0级开始)第0个节点号为:2^2+0=4 (D)
LMS系统参数
h:树的高度
m:与每个节点关联的字节数,等于hash摘要长度
H:第二个抗二次原像攻击的加密哈希函数,接受任意长度返回m字节字符串
树总共有2h叶子节点,2h-1非叶节点,一共2h+1-1节点
LMS签名的总体强度由==LM-OTS中使用的哈希函数和LMS系统中使用的哈希函数==中较弱的一个决定。为了将风险降至最低,这两个哈希函数应该相同(以便攻击者无法利用较弱的哈希函数选择)。
| Name | H | m | h | 非叶节点数 | 叶节点数 |
|---|---|---|---|---|---|
| LMS_SHA256_M32_H5 | SHA256 | 32 | 5 | 31 | 32 |
| LMS_SHA256_M32_H10 | SHA256 | 32 | 10 | 1023 | 1024 |
| LMS_SHA256_M32_H15 | SHA256 | 32 | 15 | 32767 | 32768 |
| LMS_SHA256_M32_H20 | SHA256 | 32 | 20 | 1048575 | 1048576 |
| LMS_SHA256_M32_H25 | SHA256 | 32 | 25 | 33554431 | 33554432 |
LMS私钥
LMS私钥的格式是实现的内部问题,本文档不尝试对其进行定义。一种可能性是,它可能由2<sup>h</sup> LM-OTS私钥的OTS_PRIV[]数组和尚未使用的下一个LM-OTS私钥的叶编号q组成。OTS_PRIV[]的第q个元素是使用带有标识符I,q的算法0生成的。创建LMS私钥时,叶编号q初始化为零(==即q取值范围[0,2<sup>h</sup>-1]==)。程序如下:
结构体
//标准文档没有对其进行定义
//自定义:整个LMS系统的私钥(一次性计算所有私钥)
typedef struct {
    uint32_t lms_type; //lms算法类型
    uint32_t ots_type; //ots算法类型
    //2^h为叶节点数,LM-OTS规定了私钥=ots_type||I||q||x[0]||...||x[p],其中x[i]=H(I||q||u16(i)||ff||seed)
    uint8_t  lm_ots_key[2^h][32];//32为sha256输出字节长度,已经是计算完成好的私钥(q和seed不需要保存,q是从0到2^h-1的遍历)
    uint32_t q; //尚未使用的叶编号(下一个签名要计算的密钥编号)
    uint8_t I[16]; //LMS私钥的16字节标识符
} lms_sk_t;

//自定义:考虑lm_ots_key存储太大,私钥可以实时计算,根据I, q和seed
//对于整个LMS系统,OTS私钥共2^h个
typedef struct {
    uint32_t lms_type; //lms算法类型
    uint32_t ots_type; //ots算法类型
    uint8_t  seed[16]; //随机化种子,用于实时生成私钥,LM-OTS规定了私钥=ots_type||I||q||x[0]||...||x[p],其中x[i]=H(I||q||u16(i)||ff||seed)
    uint32_t q; //尚未使用的叶编号(下一个签名要计算的密钥编号),q的取值范围[0,2^h-1]
    uint8_t I[16]; //LMS私钥的16字节标识符
} lms_sk_t;
流程
算法5:计算LMS私钥
-
根据typecode和表2确定h和m (附录A提到m是hash输出字节数,m字节随机值)
-
将l设置为均匀随机的16字节字符串
-
计算数组OTS_PRIV如下
```C
for ( q = 0; q < 2^h; q = q + 1) //q代表叶编号
{
OTS_PRIV[q] = LM-OTS private key with identifiers I, q
}
//附录A规定了LMS私钥的生成
//l为16字节,SEED为m字节,m为H输出字节数,在开始时统一生成
x_q[i] = H(I || u32str(q) || u16str(i) || u8str(0xff) || SEED). //私钥长度固定,为32字节
```
LMS私钥可以从秘密值伪随机生成;在这种情况下,秘密值必须至少为m字节长且均匀随机,并且不得用于除生成LMS私钥之外的任何其他目的。如何完成该过程的细节不会影响互操作性;也就是说,公钥验证操作独立于这些细节。附录A提供了用于计算LMS私钥的伪随机方法的示例。
LMS公钥
LMS公钥定义如下,其中我们将与第i个LM-OTS私钥相关联的公钥最终散列值(即在算法1中计算的K值)表示为OTS_PUB_hash[i],i的范围为0到(2h)-1,即非叶子节点数量。LMS公钥/私钥对的每个实例都与一个平衡二叉树相关联,该树的节点索引范围为1到2(h+1)-1,即所有节点包含叶子和非叶子节点的数量。每个节点都与一个m字节字符串相关联。第r个节点的字符串表示为T[r]
结构体
typedef struct {
uint32_t lms_type;   //lms算法类型
uint32_t lm_ots_type;//lm_ots算法类型
uint8_t pk_root[32]; //sha256哈希值
uint8_t I[16];       //LMS公私钥16字节唯一标识符
} scl_lms_pk_t
流程
输入:
p,w:用户指定LM-OTS参数集,取自公钥结构体
h:用户指定LMS参数集,取自公钥结构体
q:LMS中OTS私钥编号,对应Merkle树叶节点,取值范围[0, 2^h-1]
I:LMS公私钥16字节唯一标识符,取自公钥结构体
输出:
pk_root:LMS公钥的hash部分
//即OTS_PUB_hash[i]=K = H(I || u32str(q) || u16str(D_PBLC) || y[0] || ... || y[p-1]) // D_PBLC=0x8080
for(i=0;i<p;i++)//LMS叶编号
{
    //计算LM-OTS私钥
    tmp[i] = H(I || u32str(q) || u16str(i) || u8str(0xff) || SEED)
    //计算LM-OTS公钥
    for(j=0;j<2^w-1;j++)
    {
        tmp[i] = H(l || u32str(q) || u16str(i) || u8str(j) || tmp[i])
    }
}
K = H(l || u32str(q) || u16str(D_PBLC) || tmp[0] || ... || tmp[p-1])//D_PBLC=0x8080


for(r=2^(h+1)-1;r>0;r--)//r代表所有节点包含叶子节点
{
    if (r >= 2^h)
        //散列LM-OTS公钥
        T[r] = H(I||u32str(r)||u16str(D_LEAF)||ost_pub_hash[r-2^h])//D_LEAF值0x8282
    else
        //合并散列左右节点, 处理的是一个内部节点——也就是说,一个节点有两个子节点,需要合并
        T[r] = H(I||u32str(r)||u16str(D_INTR)||T[2*r]||T[2*r+1])//D_INTR值0x8383
}

//公钥标准格式:u32str(lmstype) || u32str(otstype) || I || T[1]
pk_root = T[1]
LMS公钥可以表示为字节字符串:u32str(type) || u32str(otstype) || I || T[1],一共是4+4+16+32=56字节
流程(存储优化1)
上述存储资源太大,需要保存所有的节点,需要优化,空间复杂度O(2^h)降至O(h)
top=0
uint8_t T_h_stack[25+1][32];
uint32_t T_idx_stack[25+1];

//计算LMS所有叶节点LM-OTS公钥,最原始计算,不考虑并行hash,不考虑资源优化
for(q=0;q<2^h;q++) //LMS叶编号
{
    H_init(ctx0)
    H_update(ctx0, I, 16)
    H_update(ctx0, q, 4)
    H_update(ctx0, D_PBLC, 2)//D_PBLC=0x8080

    for(i=0;i<p;i++)
    {
        //计算LM-OTS私钥
        H_init(ctx1)
        H_update(ctx1, I, 16)
        H_update(ctx1, q, 4)
        H_update(ctx1, i, 2)
        H_update(ctx1, 0xff, 1)
        H_update(ctx1, SEED, 32)
        tmp1 = H_final(ctx1)

        //计算LM-OTS公钥
        for(j=0;j<2^w-1;j++)
        {
            H_init()
            H_update(ctx1, I, 16)
            H_update(ctx1, q, 4)
            H_update(ctx1, i, 2)
            H_update(ctx1, j, 1)
            H_update(ctx1, tmp, 32)
            tmp1 = H_final(ctx1)
        }
        H_update(ctx0, tmp1, 32)
    }

    //LM-OTS公钥
    tmp0 = H_final(ctx0)
    //散列LM-OTS公钥
    r = i + (1<< h) //计算叶节点在Merkel树编号
    tmp0 = H(I||u32str(r)||u16str(D_LEAF)||tmp0)//D_LEAF值0x8282

    //计算LMS根公钥
    if (i != 0)
        top++;

    // 压栈
    T_h_stack[top] = tmp0
    T_idx_stack[top] = i + (1<< h)

    while (top >= 1) //至少存在两个节点,判断是否需要合并
    {
        // 判断top两个节点是否是相邻节点
        if (T_idx_stack[top] == (T_idx_stack[top - 1] + 1))
        {
            //更新父节点编号
            T_idx_stack[top-1] = T_idx_stack[top-1] / 2

            //合并计算hash更新到父节点: H(I||u32str(r)||u16str(D_INTR)||T[2*r]||T[2*r+1])
            r = T_idx_stack[top-1]
            r = ((r << 24) | ((r & 0x0000FF00) << 8) | ((r & 0x00FF0000) >> 8) | (r >> 24));
            H_Init(ctx)
            H_update(ctx, I_buf, 16)
            H_update(ctx, &r, 4)
            H_update(ctx, intr_buf, 2)
            H_update(ctx, T_h_stack[top-1], 32)
            H_update(ctx, T_h_stack[top], 32)
            H_final(ctx, T_h_stack[top - 1])

            //更新top
            top--;
        }
        else
        {
            break;
        }
    }
}

return T_h_stack[0]
流程(存储性能优化)
//pqc ram一些存储
uint32_t  top=0xffffffff;
uint8_t h_stack[25][32]
uint8_t h_tmp0[32]
uint32_t tmp_r

//pqc ram一些存储
hash_ip_num = m+1         //假设可以同时使用m+1个hash IP,chain链并行m条
uint32_t tmp_m            //临时存储
uint8_t sk[m][16+4+2+1+32] //z[i]=I||u32str(q)||u16str(i)||u8str(j)||x

//预处理待hash的m条链数据,I和q,seed存储
for(k=0; k<m; k++)
{
    memcpy(sk, I, 16)
    memcpy(sk+16, q, 4)
    memcpy(sk+23, SEED, 32)
}

//计算LMS所有叶节点LM-OTS公钥
for(q=0;q<2^h;q++) //LMS叶编号
{
    H_init(hw_idx_0)
    H_update(hw_idx_0, I, 16)
    H_update(hw_idx_0, q, 4)
    H_update(hw_idx_0, D_PBLC, 2)//D_PBLC=0x8080

    for(i=0;i<p;;)
    {
        //获取本次并行的chain数量
        if ((p-i) >= m)
        {
            tmp_m = m
            i += m
        }
        else
        {
            tmp_m = p-i
            i = p
        }

        //并行计算m个LM-OTS私钥
        for(k=0; k<tmp_m; k++)
        {
            sk[k].i = i //在sk中更新i值
            sk[k].j = 0xff //在sk中更新j值
            H_start(hw_idx_k+1, sk[k], 16+4+2+1+32) //启动hash计算
        }

        //等待m个LM-OTS私钥计算完成
        for(k=0; k<tmp_m; k++)
        {
            wait H(hw_idx_k+1)
            sk[k].x = H_get(hw_idx_k)
        }

        //并行计算m个LM-OTS公钥
        for(j=0;j<2^w-1;j++)
        {
            for(k=0; k<tmp_m; k++)
            {
                sk[k].j = j //在sk中更新j值
                H_start(hw_idx_k+1, sk[k], 16+4+2+1+32) //启动hash计算
            }

            //等待m个链hash计算完成
            for(k=0; k<tmp_m; k++)
            {
                wait H(hw_idx_k+1)
                sk[k].x = H_get(hw_idx_k)
            }
        }
        //将m个pk合并计算
        for(k=0; k<tmp_m; k++)
            H_update(hw_idx_0, sk[k].x, 32)

        if ((p-i) >= m)
            i += m
        else
            i = p
    }

    //获取LM-OTS公钥
    h_tmp0 = H_final(hw_idx_0)
    //散列LM-OTS公钥
    r = i + (1<< h) //计算叶节点在Merkel树编号
    h_tmp0 = H(hw_idx_0, I||u32str(r)||u16str(D_LEAF)||h_tmp0)//D_LEAF值0x8282

    j = i;
    while ((j % 2) == 1) //至少存在两个节点
    {
        r = (r - 1) / 2;
        j = (j - 1) / 2;
        tmp_r  = ((r << 24) | ((r & 0x0000FF00) << 8) | ((r & 0x00FF0000) >> 8) | (r >> 24));
        H_Init(hw_idx_0);
        H_update(hw_idx_0, I_buf, 16);
        H_update(hw_idx_0, &tmp_r, 4);
        H_update(hw_idx_0, 0x8383, 2);
        H_update(hw_idx_0, h_stack[top], 32);
        H_update(hw_idx_0, node, 32);
        h_tmp0 = H_final(hw_idx_0);
        top--;
    }
    top++;
    memcpy(h_stack[top], node, 32);
}

return h_stack[top]
结构体定义
enum lmots_algorithm_type {
 lmots_reserved       = 0,
 lmots_sha256_n32_w1  = 1,
 lmots_sha256_n32_w2  = 2,
 lmots_sha256_n32_w4  = 3,
 lmots_sha256_n32_w8  = 4
};
struct lms_key_n32 {
    lmots_algorithm_type ots_alg_type;
    opaque I[16];
    opaque K[32];
};

//自定义:这里我理解为私钥和公钥的密钥对结构体定义
struct lms_pubkey {
    uint32_t lms_type; //lms算法类型
    uint32_t ots_type; //ots算法类型
    uint8_t K[32]; //K=H(u32str(type)||u32str(otstype)||I||T[1]),这里的type指lms的type,标准里面指定的type暂时理解为不保存在结构体中,由外部保存
};
结合LM-OTS,合并逻辑
//lms公钥结构体
typedef struct {
uint32_t lms_type;   //lms算法类型
uint32_t lm_ots_type;//lm_ots算法类型
uint8_t pk_root[32]; //sha256哈希值
uint8_t I[16];       //LMS私钥的16字节标识符
} scl_lms_pk_t
//计算LMS所有叶节点LM-OTS公钥,最原始计算,不考虑并行hash,不考虑资源优化
for(q=0;q<2^h;q++) //LMS叶编号
{
    for(i=0;i<p;i++)
    {
        //计算LM-OTS私钥
        tmp[i] = H(I || u32str(q) || u16str(i) || u8str(0xff) || SEED)
        //计算LM-OTS公钥
        for(j=0;j<2^w-1;j++)
        {
            tmp[i] = H(I || u32str(q) || u16str(i) || u8str(j) || tmp[i])
        }
    }
    OTS_PUB_HASH[q] = H(l || u32str(q) || u16str(D_PBLC) || tmp[0] || ... || tmp[p-1])//D_PBLC=0x8080
}

//计算LMS根公钥,最原始计算,不考虑并行hash,不考虑资源优化
for(r=2^h-1;r>0;r--)
{
    if (r >= 2^h)
        //处理一个叶节点(因此仅散列一个LM-OTS公钥),可以看出D_LEAF和D_INTR区别
        T[r] = H(I||u32str(r)||u16str(D_LEAF)||OTS_PUB_HASH[r-2^h])//D_LEAF值0x8282
    else
        //处理的是一个内部节点——也就是说,一个节点有两个子节点,需要合并
        T[r] = H(I||u32str(r)||u16str(D_INTR)||T[2*r]||T[2*r+1])//D_INTR值0x8383
}

//公钥标准格式:u32str(lmstype) || u32str(otstype) || I || T[1]
pk_root = T[1]
LMS签名
与LM-OTS签名关联的叶的编号q,作为网络字节顺序的四字节无符号整数,一个LM-OTS签名,typecode表示特定LMS算法类型代码,一个数组包含h、m字节值,与从LM-OTS签名关联的叶到根的树路径关联
从象征意义上讲,签名可以表示为u32str(q) || lmots_signature || u32str(type) || path[0] || path[1] || path[2] || ... || path[h-1],==注意,path[0]是叶子节点层==
其中:lmots_signature = u32str(type) || C || y[0] || ... || y[p-1] (实际应用中可能不需要type,需要在官方c model确认)
由上可知,签名值的长度为:4 +(32+32 * p)+ 4 + (32 * h)
结构体
签名流程使用scl_lms_sig_t和消息
typedef struct {
uint8_t sig[LMS_SIG_MAX_LEN]; //签名值
uint32_t siglen; //签名值长度,取决于参数集lms_ots的p和lms的h
} scl_lms_sig_t

//合并私钥结构体
//自定义:考虑lm_ots_key存储太大,私钥可以实时计算,根据I, q和seed
//对于整个LMS系统,OTS私钥共2^h个
struct lms_privkey {
    uint32_t lms_type; //lms算法类型
    uint32_t ots_type; //ots算法类型
    uint8_t  seed[16]; //随机化种子,用于实时生成私钥,LM-OTS规定了私钥=ots_type||I||q||x[0]||...||x[p],其中x[i]=H(I||q||u16(i)||ff||seed)
    uint32_t q; //尚未使用的叶编号(下一个签名要计算的密钥编号),q的取值范围[0,2^h-1]
    uint8_t  I[16]; //LMS私钥的16字节标识符
    uint8_t  *msg;
    uint8_t  *msg_len;
};

//在标准3.3章节中,正式将lmots_signature做了定义,占用的范围参考定义对应的lmots_signature_nXX_pXX
   enum lmots_algorithm_type {
     lmots_reserved       = 0,
     lmots_sha256_n32_w1  = 1,
     lmots_sha256_n32_w2  = 2,
     lmots_sha256_n32_w4  = 3,
     lmots_sha256_n32_w8  = 4
   };

   struct lmots_signature_n32_p265 {
     bytestring32 C;
     bytestring32 y[265]; //y的范围即p的值,p的值由lmots_algorithm_type决定参数值
   };

   struct lmots_signature_n32_p133 {
     bytestring32 C;
     bytestring32 y[133];
   };

   struct lmots_signature_n32_p133 {
     bytestring32 C;
     bytestring32 y[133];
   };

   struct lmots_signature_n32_p67 {
     bytestring32 C;
     bytestring32 y[67];
   };

   struct lmots_signature_n32_p67 {
     bytestring32 C;
     bytestring32 y[67];
   };

   struct lmots_signature_n32_p34 {
     bytestring32 C;
     bytestring32 y[34];
   };

   struct lmots_signature_n32_p34 {
     bytestring32 C;
     bytestring32 y[34];
   };

   union lmots_signature switch (lmots_algorithm_type type) {
    case lmots_sha256_n32_w1:
      lmots_signature_n32_p265 sig_n32_p265;
    case lmots_sha256_n32_w2:
      lmots_signature_n32_p133 sig_n32_p133;
    case lmots_sha256_n32_w4:
      lmots_signature_n32_p67  sig_n32_p67;
    case lmots_sha256_n32_w8:
      lmots_signature_n32_p34  sig_n32_p34;
    default:
      void;   /* error condition */
   };
流程
要使用LMS私钥计算消息的LMS签名,签名者首先使用下一个未使用的LM-OTS私钥的叶编号计算消息的LM-OTS签名。签名中的叶编号q设置为签名中使用的LMS私钥的叶编号。在释放签名之前,必须增加LMS私钥中的叶编号q,以防止再次使用LM-OTS私钥
从象征意义上讲,签名可以表示为u32str(q) || lmots_signature || u32str(type) || path[0] || path[1] || path[2] || ... || path[h-1]
其中:lmots_signature = u32str(type) || C || y[0] || ... || y[p-1] (实际应用中可能不需要type,需要在官方c model确认)
由上可知,签名值的长度为:4 +(32+32 * p)+ 4 + (32 * h)
                                Root
                                 |
                 ---------------------------------
                 |                               |
               T[2]*                          T[3]**
                 |                               |
          ------------------            -----------------
          |                |            |               |
       T[4]**           T[5]*         T[6]            T[7]
          |                |            |               |
      ---------       ----------     --------       ---------
      |       |       |        |     |      |       |       |
     leaf    leaf    OTS  leaf**   leaf   leaf    leaf    leaf
上面是h=3,q=2的身份验证路径的简单示例。
- 标记为OTS的叶子节点是用于对实际消息的一次性签名
- path[0]是与OTS公钥(叶节点q)相邻的叶节点(路径起点),如图leaf**
- path[1]是路径上第二个节点T[5]的同级节点T[4]*节点,即与叶节点q的父节点相邻
- path[2]是路径上第三个节点T[2]的同级节点T[3]*节点
验证思想:。验证器所做的是重新计算路径上的散列;首先,它散列给定的OTS和路径[0]值,给出一个暂定的T[5]值。然后,它散列其路径[1]和暂定T[5]'值,以获得暂定T[2]'值。然后,它将其与路径[2]值散列,以获得一个暂定的根值。如果该值是Merkle树的已知公钥,那么我们可以假设它得到的值T[2]是原始树中正确的T[2]值,因此它得到的值T[5]是原始树中正确的T[5]值,因此OTS公钥与原始树中相同,因此是正确的。
生成LMS签名流程:
-
将type设置为LMS算法的typecode
-
根据表2,从类型代码中提取h
-
为消息创建LM-OTS签名 //lmots_signature = u32str(type) || C || y[0] || ... || y[p-1]
-
按如下方式计算数组路径
```C
i = 0
r = 2^h + q //获取叶节点在整个M树的编号[1, 2^(h+1)-1]
while (i < h)
{
temp = (r / 2^i) xor 1 //节点编号/2,第0比特取反,就是该节点的父节点的相邻节点
path[i] = T[temp]
i = i + 1
}
//优化一下r
i = 1
r = 2^h + q //获取叶节点在整个M树的编号[1, 2^(h+1)-1]
path[0] = T[r xor 1]
while (i < h)
{
r = (r / 2) xor 1 //节点编号/2,第0比特取反,就是该节点的父节点的相邻节点
path[i] = T[r]
i = i + 1
}
```
-
S = u32str(q) || ots_signature || u32str(type) || path[0] || path[1] || ... || path[h-1],其中ots_signature为u32str(type) || C || y[0] || ... || y[p-1]
-
q=q+1
-
return S
LMS签名验证
结构体
使用公钥和签名值验证
流程
输入:
q:LMS中OTS私钥编号,取值范围[0, 2^h-1],取自签名值
p, w:LM-OTS参数集指定,取自公钥结构体
I:LMS公私钥16字节唯一标识符,取自公钥结构体
C:32字节随机值,取自签名值lmots_signature部分
T[1]:LMS公钥,32字节hash值,取自公钥结构体
message:外部用户指定的待验签的原始消息
输出:
验签结果,成功或失败
首先使用LM-OTS签名验证算法(算法4b)验证LMS签名,以根据LM-OTS签名和消息计算LM-OTS公钥。然后将该公钥的值分配给LMS树的关联叶,然后根据叶值和数组路径[]计算树的根,如下面的算法6所述。如果根值与公钥匹配,则签名有效;否则,签名验证将失败。
算法6:LMS签名验证
- 如果公钥长度不超过8个字节,则返回INVALID
- 从公钥解析pubtype、I和T[1]
- )pubtype=strTou32(公钥的前4个字节)
- )ots_typecode=strTou32(公钥的下4个字节)
- )Set m according to pubtype, based on Table 2 //m恒定32
- )如果公钥的长度不是24+m字节,则返回INVALID
- )I=公钥的下一个16字节
- )T[1]=公钥的下一个m字节
- 使用算法6a从签名、消息、标识符、pubtype和ots_类型码计算LMS公钥候选Tc
- 如果Tc等于T[1],则返回有效;否则,返回无效
算法6a:根据签名、消息、标识符和算法类型码计算LMS公钥候选
-
如果签名长度不超过8字节,则返回INVALID
-
按如下方式解析签名的sigtype、q、lmots_签名和路径
-
)q=strTou32(签名的前4个字节)
- )otssigtype=strTou32(签名的下4个字节)
- )如果otssigtype不是公钥中的OTS类型代码,则返回INVALID
- )根据otssigtype和表1设置n、p;如果签名长度不超过12+n*(p+1)字节,则返回INVALID
- )lmots_signature = bytes 4 through 7 + n * (p + 1) of signature
-
)sigtype = strTou32(bytes 8 + n * (p + 1)) through 11 + n * (p + 1) of signature)
-
)如果sigtype不是公钥中的LM typecode,则返回INVALID
- )根据sigtype和表2设置m、h
- )如果q>=2^h或签名的长度不完全是12+n*(p+1)+m * h字节,则返回INVALID
- )按如下方式设置路径:
C
   path[0] = next m bytes of signature
   path[1] = next m bytes of signature
   ...
   path[h-1] = next m bytes of signature
-
Kc=通过将算法4b应用于签名lmots_signature、消息和标识符I、q而计算的候选公钥
-
计算候选LMS根值Tc如下
//获取OTS公钥,Kc是计算指定叶子节点的OTS公钥,占用32字节
Q = H(l || u32str(q) || u16str(D_MESG) || C || message)//D_MESG=0x8181
for ( i = 0; i < p; i = i + 1 )
{
    a = coef(Q || Cksm(Q), i, w)
    tmp = y[i]
    for ( j = a; j < ((1<<w) - 1); j = j + 1 )
    {
        tmp = H(l || u32str(q) || u16str(i) || u8str(j) || tmp)
    }
    z[i] = tmp
}
Kc = H(l || u32str(q) || u16str(D_PBLC) || z[0] || z[1] || ... || z[p-1])
//对指定叶子节点OTS公钥做hash
node_num = (1<<h) + q //根据指定叶编号q获取整颗树节点编号(包含叶子节点和非叶子节点)
tmp = H(I || u32str(node_num) || u16str(D_LEAF) || Kc) //D_LEAF为0x8282
i = 0
while (node_num > 1) //一共执行h次
{
    if (0!= (node_num&1))
        //当前节点是右子节点
        tmp = H(I||u32str(node_num/2)||u16str(D_INTR)||path[i]||tmp) //D_INTR为0x8383
    else
        // 当前节点是左子节点
        tmp = H(I||u32str(node_num/2)||u16str(D_INTR)||tmp||path[i])
    //获取上一层父节点
    node_num = node_num/2
    i = i + 1
}
Tc = tmp

return
项目上的TASK结构体定义
typedef struct {
uint32_t cfg;         //keygen, sign, verify, []:init/update/final, []:决定是否吐出hash中间值
volatile uint32_t sw; //result
} scl_base_task_t

typedef struct {
uint32_t lms_type;   //lms算法类型
uint32_t lm_ots_type;//lm_ots算法类型
uint8_t pk_root[32]; //sha256哈希值,参与计算的I值存储在私钥,验签不需要计算该
uint8_t I[16];       //LMS私钥的16字节标识符
} scl_lms_pk_t

typedef struct {
uint32_t lms_type;    //lms算法类型
uint32_t lm_ots_type; //lm_ots算法类型
uint8_t  sk_seed[16]; //种子, 用于ots私钥生成
uint32_t q;          //尚未使用的叶编号(用于下一次签名),lms_type决定q的取值范围[0,2^h-1]
uint8_t I[16];       //LMS私钥的16字节标识符
} scl_lms_sk_t

typedef struct {
//sig = u32str(q)||lmots_signature||u32str(type)||path[0]||path[1]||path[2]||...||path[h-1]
//lmots_signature = u32str(type)||C||y[0]||...||y[p-1]
uint32_t lms_type;    //lms算法类型
uint32_t lm_ots_type; //lm_ots算法类型
uint8_t sig[LMS_SIG_MAX_LEN]; //4+(32+32*p)+4+(32*h), p取最大值265,h取最大值25,取决于参数集选择p和h
uint32_t siglen; //签名长度取决于参数集lms_ots的p和lms的h
} scl_lms_sig_t


typedef struct {
scl_base_task_t base;
scl_lms_pk_t *lms_pk;
scl_lms_sk_t *lms_sk;
scl_lms_sig_t *lms_sig;
uint8_t *msg;
uint32_t msglen;
uint8_t *l_tmp;
uint32_t *l_tmplen;
} scl_lms_task_t
安全字符串
为了提高对攻击的安全性,这些攻击会分散他们对哈希函数多次调用的精力,Leighton和Micali引入了一个“安全字符串”,该字符串对于该函数的每次调用都是不同的。每当此进程计算散列时,被散列的字符串将以以下字段形成的字符串开始。这些字段将出现在我们计算散列值的固定位置,因此我们列出这些字段在散列中的位置。组成此字符串的字段如下所示:
I :LMS公钥/私钥对的16字节标识符。在生成密钥对时,必须随机或通过伪随机过程均匀地选择该密钥,以最小化I的任何特定值用于大量不同LMS私钥的概率。这始终是散列值的0-15字节
r:在LMS N时间签名方案中,与散列树的特定节点相关联的节点号r被用作用于计算该节点的散列的输入。此值表示为网络字节顺序的32位(四字节)无符号整数。r或q(取决于域分隔参数)将是散列值的字节16-19。
q:在LMS N时间签名方案中,每个LM-OTS签名都与哈希树的叶子相关联,并且q被设置为叶子编号。这可确保每个不同的LM-OTS公钥/私钥对使用不同的q值。此值表示为网络字节顺序的32位(四字节)无符号整数。r或q(取决于域分隔参数)将是散列值的字节16-19。
D:一个域分离参数,它是一个双字节标识符,在调用哈希函数的不同上下文中具有不同的值。D出现在被散列的值的字节20和21中,并采用以下值:
计算LM-OTS算法中所有迭代的哈希时,D_PBLC=0x8080
在LM-OTS算法中计算消息哈希时,D_MESG=0x8181
计算LMS树的叶散列时,D_LEAF=0x8282
计算LMS树内部节点的哈希时,D_INTR=0x8383
i:值介于0和264之间;当计算Winternitz链的迭代次数或使用建议的LM-OTS私钥生成过程时,这在LM-OTS方案中使用。它表示为网络字节顺序的16位(两字节)无符号整数。如果存在,它出现在被散列的值的字节20和21处。
j:在LM-OTS方案中,j是迭代散列私钥元素时使用的迭代数。它表示为一个8位(一字节)无符号整数,如果i是一个介于0和264之间的值,则存在该整数。如果存在,它出现在被散列的值的字节22到21+n处。
C:一个n字节的随机化器,每当对消息进行哈希处理以提高安全性时,它都包含在消息中。C必须随机或通过另一个不可预测的过程统一选择。如果D=D_MESG,则存在该值,它出现在被散列值的字节22到21+n处。
官方C model分析
官方c model链接:https://github.com/cisco/hash-sigs
该模型会输出如下文件:
【keyname.aux】:目前还没有仔细分析里面的数据组成,结合代码分析是预计算数据
【keyname.prv】:
数据结构组成:
//demo w8 h5
  keyname.prv(私钥文件)- 总长度56字节

  实际数据分析:
  00000000: 0000 0000 0000 0001 64ff ffff ffff ffff  ........d....... //counter||set_depress
  00000010: 0000 0000 0000 0000 0000 0000 0000 0000  ................ //seed
  00000020: 0000 0000 0000 0000 0000 0000 0000 0000  ................
  00000030: 1000 0000 0000 0000 0000 0000 0000 0000  ................ //I

  keyname.prv = str8(q)||str8(set)||str32(seed)||str16(I)

  1. 字节0-7 (PRIVATE_KEY_INDEX): 00 00 00 00 00 00 00 01    //q - 4byte
    - 当前签名计数器,值为1(大端字节序)
    - 表示已经使用了1次签名
  2. 字节8-15: 64 ff ff ff ff ff ff ff
    - 参数集压缩数据的一部分
    - 64 = 十进制100,可能是w参数或其他参数配置
  3. 字节16-47: 全0  //seed
  4. 字节48-63: 10 00 00 00 00 00 00 00 00 00 00 00 00 00 00 00 //I
【keyname.pub】:
数据结构组成:
//demo w8 h5
  keyname.pub(公钥文件)- 总长度60字节

  实际数据分析:
  ⎿  00000000: 0000 0001 0000 0005 0000 0004 1000 0000  ................
     00000010: 0000 0000 0000 0000 0000 0000 ee75 d868  .............u.h
     00000020: cced dfdd 57d1 0a9c 889a 6df4 1e03 efde  ....W.....m.....
     00000030: 2af2 c6e0 5831 d594 6e75 3b0b            *...X1..nu;.

  keyname.pub = str4(HSS high)||str4(lms_type)||str4(lm ots type)||str16(I)||str32(root)

  1. 前4字节 - HSS层级数
    - 格式:4字节大端字节序整数
    - 含义:HSS签名方案的层级数量
  2. 第4-7字节 - LM类型参数
    - 格式:4字节大端字节序整数
    - 含义:Merkle树的参数类型
  3. 第8-11字节 - LM-OTS类型参数
    - 格式:4字节大端字节序整数
    - 含义:一次性签名方案的参数类型
  4. 第12-27字节 - 标识符I
    - 长度:16字节 (I_LEN = 16)
    - 含义:密钥对的唯一标识符
  5. 第28-59字节 - 根哈希值
    - 长度:32字节 (MAX_HASH = 32,对于SHA-256)
    - 含义:Merkle树的根哈希值,用于验证签名
【msg.txt】:待签名的原始消息
//demo w8 h5 16进制
//80字节
3132333435363738313233343536373831323334353637383132333435363738313233343536373831323334353637383132333435363738313233343536373831323334353637383132333435363738
【msg.txt.sig】
数据结构组成:
//demo w8 h5

//HSS层级数减1(L-1)
00000000
// q (4 bytes)
00000002
// LMOTS_SHA256_N32_W8 (4 bytes)
00000004
// C (32 bytes)
df5f5fdeddd39038432ea36f9afd5510075fd03609106d81a457ef70003a019f
// y[0]||...||y[p-1] (34*32 = 1088 bytes)
c371ecb5b5d5bbda59bc1098ce8a1e7ae62676a30d14707e305c8b3b36213d3a
19ce9cd221a5586125f9865d9ad443d1743573607006d0b3fe40d4707aa35325
300c80d76ad23c6f0a8c116d4c3d47809994706058bd64b6d78e4ca57a77f9c9
b4fbc38a4d040e0eca7fd0060e5a616249076a99faf4b9ec2c440070c9de52f2
f43973c513b1b38419218debd34104991219dbbf3e6969e71cd5911a6d352657
6fcb890518d2a360fad59e3ecf43b349481ca7b2498f6f4c160aceeaa357e74e
64d152489d354ae1e34d01bcb0da7736d5e4abca3a6a4f5485b63af76aad651a
197a74fa1233002bc0cd87608d4bb4154a489e0f500a22d31b04c79c2303d621
8332f8cd1910586bdc621f5841fd3a624033ba9255b6a855e25efc0fbcec806d
9bd982146f6fcbc52d25df802809f4d194edcd41aad83a2554851a14440ede1d
607cad6eecae5e693fb37334d65675866b898b469ff11bb204f6f7ad86e9a163
005d8bf485488d6a8c6773006ebc571e87487e5892e73c2abb6dc00d7f5bbadd
c34347a46517e410f70625c084cd3d85c7c17dab9fd2b5ad47c2fa80dc745b8d
07b6c5a8145604bf1047ae539b32599549ee7dc1e1a20237c90ae437e0742845
174256d2ea15e9e8575594e1823af0c2fa43af99fb57065f1752c2d0751087a5
a9f3818bef618978d80b7d8fcf215fca116b49b859b94092ed232153caaed6d6
113c50b07c12e2173b29eb9ebf44c03111867c5c6e19eb0c1155ea231c76ebda
f4d17e2d12376f9f1722fc0a3789874d0b268d12db65c6510df41af8e7b91b0e
5211831f7954085fc2d29cc5664b3c7531e889d123638be117adfa1db6b4d12e
ec4195a79a1159e6dd0b9dd2e81fed24ce33527d2b6cc6e30c6f7743481e6621
bcf335ccb43dcc6cf2437d62b530dae37b07e0f04bfaf91c92f31d3ba00fdeef
4fc0c52bc2aa796a1b1765e66999fb9f93ae6c33689dc802e49fb316e95e8119
66065a3b3bcd2ad12ac01cafaec628f2a842d47b6d020c58f986d67177804658
85b7a29044a85b069ffcdb5ecddec5ba7122ba4f3888a32a47ebe4c44702e89f
ebab940f7c5fd9ba92aeef8363e7da92acb79681f50c58b85ff0ba3e2f5731e2
e509260844b808d0023a46b15c133243a1e4d753c939d99e9d0d5a7b5e74a475
2a8d654a69b99c41fc445ff843dba809b97682a0197066682973fc9e14c97378
a52dd3b575b55d8a7f75b7963f676836321c0e07d19367d8cb41b813fbbc9a00
cdc2a66116c889752fb88fcffa09b7153d7d67c167800271d47f6041c7577a19
8882e6d263a619f05e1a067bd4eadf90866f5a5282daf6d786cad134b25c118a
e1328c4db11934de8ad031f4da53051c2d3a3ec6f21af748e90cb7a1026b910e
c3092eb023f4cd74745e99c5e38f725a296b47d9d7ce1d9471bcdd7d75369e76
2ce89c663aefe2ac80355bb9ae4d7f6dad1f7a30eea7a4ed376088a8909c7468
11078e27e7a40ab32bd58a8082490b515f164f2f84559e49b1ab142c3f90d05c
// LMS_SHA256_M32_H5 (4 bytes)
00000005
// path[0]||...||path[h-1] (5*32 = 160 bytes)
abc80a13a7910f4af6efca10be4575edb5c336bc5c1a6d991d4edd898bbbb50a
ffd75ef07a4c1e2c1f51dc10a9acf54fbe8ab93b79fcd820ca6c8ec7f249609c
1efde58c816132cc74beed6b5790615faf2d499cf06eca583466a1fde205d2a3
d348a557e94b9981f7e0609aa3d82691aa45f87ab95b493a42fdd0188f337286
4c446423d7cc93b9ed731be8b1bf40c6a97f83f325be7c2c440ac2a5fe59d087
其他
这是基于hash的签名PQC方案
对于一颗高度为h的二叉Merkle树(LMS中通常使用二叉树):
1.叶子节点的数量为2h,每个叶子节点对应一个OTS密钥对,因此一颗高度h的树可管理2h个OTS密钥对
One Time Signatures
one bit
1979,Leslie Lamport:One Time Signatures(OTS)
1. If need ti sign 0, publish x = x0
2. If need to sign 1,pushlish x=x1
3. Verify by H(x) = y0 or y1
上述是对于1比特的签名和验签demo
Pk :  y0     y1
     h()↑   h()↑
Sk:    x0     x1
multi bit
Pk :  y1,0     y1,1    y2,0    y2,1   y3,0   y3,1
       h()↑     h()↑     h()↑   h()↑   h()↑   h()↑
Sk:    x1,0     x1,1    x2,0    x2,1   x3,0   x3,1
举例:假设m=010,那么输出x1,0||x2,1||x3,0。(每比特有两个状态,根据m比特状态值,对应选择)
对n比特消息(原始消息已被hash处理完毕)进行签名,那么公钥长度|pk|=私钥长度|sk|=2 * n * c,签名值长度|sig| = n * c,c是hash的输入/输出长度
WOTS
1979,Robert Winternitz:Winternitz OTS(WOTS)
Pk:    H3(x1)   H3(x2)   H3(x3)   H3(x4)  H3(x5)  H3(x6)
        h()↑     h()↑     h()↑     h()↑    h()↑    h()↑
Sk2:    H2(x1)   H2(x2)   H2(x3)   H2(x4)  H2(x5)  H2(x6)
        h()↑     h()↑     h()↑     h()↑    h()↑    h()↑
Sk1:    H(x1)    H(x2)    H(x3)    H(x4)   H(x5)   H(x6)
        h()↑     h()↑     h()↑     h()↑    h()↑    h()↑
Sk0:     x1       x2       x3       x4      x5      x6
举例,假设m=011100,表示为(01||11||00),那么输出签名值=H(x1)||H3(x1)||x3...)
每一个分组包含log2(w)比特,分组的数量=n/log2(w)
在WOTS,对手可以伪造签名对于一个大数m,因此需要添加额外的检查(利用抗第一原像攻击)
Pk:    H3(x1)   H3(x2)   H3(x3)   H3(x4)  H3(x5)  H3(x6)  ... H3(xcs1)  H3(xcs2)
        h()↑     h()↑     h()↑     h()↑    h()↑    h()↑   ...  h()↑       h()↑
Sk2:    H2(x1)   H2(x2)   H2(x3)   H2(x4)  H2(x5)  H2(x6) ... H2(xcs1)  H2(xcs2)
        h()↑     h()↑     h()↑     h()↑    h()↑    h()↑   ...  h()↑       h()↑
Sk1:    H(x1)    H(x2)    H(x3)    H(x4)   H(x5)   H(x6)  ... H(xcs1)    H(xcs2)
        h()↑     h()↑     h()↑     h()↑    h()↑    h()↑   ...  h()↑       h()↑
Sk0:     x1       x2       x3       x4      x5      x6    ...  xcs1        xcs2
cs = sumi(w-1-mi),larger m leads to smaller cs(m越大,cs越小)
假设对n比特消息进行签名,公钥长度|pk| = 私钥长度|sk| = 签名值长度|sig| = (L+log2(w-1)L)/log2(w) * c,其中c是hash的输入输出长度
如上,L为分组的数量,L=n/log2(w),其中log2(w)为一个分组包含的比特数
假设w为4,i为4,cs=(4-1-m0) + (4-1-m1) + (4-1-m2) + (4-1-m3) = 4*(4-1)- sum(m0+m1+m2+m3) ,这里mi是哈希链上的值,这里是把每个
WOTS+
2013,Andreas Hulsing:WOTS+
取代hash碰撞攻击,F可以是一个PRF或抗二次原像攻击的hash函数
更小的签名具有相同的安全性
Pk:     C3k=Fk(C2k ⊕ r3)  C3k=Fk(C2k ⊕ r3)  ... C3k=Fk(C2k ⊕ r3)   C3k=Fk(C2k ⊕ r3)
           r3()↑                r3()↑                  r3()↑             r3()↑
Sk2:    C2k=Fk(C1k ⊕ r2)  C2k=Fk(C1k ⊕ r2)  ... C2k=Fk(C1k ⊕ r2)   C2k=Fk(C1k ⊕ r2)
           r2()↑                r2()↑                  r2()↑             r2()↑
Sk1:    C1k=Fk(C0k ⊕ r1)  C1k=Fk(C0k ⊕ r1)  ... C1k=Fk(C0k ⊕ r1)   C1k=Fk(C0k ⊕ r1)
           r1()↑                r1()↑                  r1()↑             r1()↑
Sk0:      C0k=x1               C0k=x2         ...       C0k=xcs1          C0k=xcs2
r1/r2/r3是随机值
Many Time Signature
1979,Merkel: Merkle Signature Scheme(MSS)
PK         H(H(PK1)||H(PK2)||H(PK3)||H(PK4))
                |                    |
        H(H(PK1)||H(PK2))      H(H(PK3)||H(PK4))
                |                    |
           |————————|           |——————————|
       H(PK1)      H(PK2)      H(PK3)     H(Pk4)
          |           |           |          |
       OTS-PK1     OTS-PK2     OTS-PK3    OTS-PK4
SK     OTS-SK1     OTS-SK2     OTS-SK3    OTS-SK4
每次使用一对密钥OTS,匹配对应的认证路径。举例,使用第一对密钥,认证路径为:H(PK2),H(H(PK3)||H(PK4))
安全性:不会重复使用一个OTS
XMSS
NIST SP 800-208 :有状态哈希签名方案推荐
-
LMS / HSS
- LMS:Leighton-Micali Signature
- HSS:Hierarchical Signature System
- 技术来源主要是 RFC 8554
-
XMSS / XMSS^MT
-
XMSS:eXtended Merkle Signature Scheme
- XMSS^MT:multi-tree XMSS
- 技术来源主要是 RFC 8391